Страница 3 из 19
Добавлено: Чт авг 16, 2007 11:32
Ник
Вот я и веду переговоры с автором FB2 to Any

Добавлено: Чт авг 16, 2007 12:54
Моторокер
Ник писал(а):Alextp писал(а):По поводу FB2: нужна утилита, которая стрипает теги
Это да - но, кроме тэгов, там есть и встроенные бинарные объекты - например, картинки - как их стрипать?
Элементарно – всё что между <binary и </binary>
Alextp писал(а):нужна утилита, которая стрипает теги. Чтобц можно было запускать так:
tags in_file out_file
Ща попробую, есть эфбэшки.
Добавлено: Чт авг 16, 2007 13:17
Alextp
Моторокер
Надо чтобы текст разделялся пробелами после стрипанья тегов.
Добавлено: Чт авг 16, 2007 13:18
Ник
Я кручу FB2 to Any.
Скрипт fb2txt_interactive.vbs работает отлично.
Скрипт fb2txt_commandline.vbs даёт ошибку на 90 строке 1 позиция - так и не понял - ошибка в скрипте или в документе - я не особо волоку в скриптах.
Посмотрите кто-нибудь, плз, - инструмент уже готовый, его, ИМХО, просто надо настроить и научиться им пользоваться.
Файлы FB2 для проверки могу прислать...
Добавлено: Чт авг 16, 2007 14:04
Моторокер
Alextp писал(а):Хорошо. Надо тоько чтобы тескт разделялся пробелами после стрипанья тегов.
Что это значит?
Просто тупо читаю всю строку, удаляю бинарики, заменяю <p> на #13#10, удаляю тэги, сохраняю строку:
xml2txt.rar (22 Kb)
Параметры – входной [и выходной] файл
Добавлено: Чт авг 16, 2007 14:48
Ник
Моторокер писал(а):Alextp писал(а):Хорошо. Надо только чтобы текст разделялся пробелами после стрипанья тегов.
Что это значит?
Значит - чтобы слова не слипались после удаления тэгов...
Добавлено: Чт авг 16, 2007 14:50
Ник
Моторокер писал(а):тупо читаю всю строку, удаляю бинарики, заменяю <p> на #13#10, удаляю тэги, сохраняю строку
Прости, но он ресурсов жрёт по ощущениям - больше, чем FB2 to Any - раз в десять!!!
Добавлено: Чт авг 16, 2007 14:57
Alextp
Что это значит?
Значит - чтобы слова не слипались после удаления тэгов...
Именно. Сейчас слипаются.
Добавлено: Чт авг 16, 2007 15:07
Ник
И потом - в FB2 идёт текст в UTF-8 - ИМХО, его нужно переделывать в Windows-1251 - ТК вроде как не работает нормально и полноценно с Уникодом (особенно без ручного выставления кодировки при поиске и просмотре).
Давайте уж договоримся, что все тексты нужно временно (пока Гислер не сделает полноценную поддержку УНикода) сводить в Windows-1251.
Или нужно делать многократный поиск: по Windows-1251, по ASCII, по KOI-8R, по UTF-8, UTF-16...
Кстати, Алексей, а нельзя ли для поисковика сделать лог-файл + показывать предупреждения, что типа это не та кодировка - не могу найти - и в конце работы писать список файлов не с той кодировкой?
Иначе легче искать AVSearch, который все эти кодировки поддерживает + RTF видит нормально...
Добавлено: Чт авг 16, 2007 15:21
Моторокер
Ник писал(а):Прости, но он ресурсов жрёт по ощущениям - больше, чем FB2 to Any - раз в десять!!!
Работает хоть быстрее?
Я же говорю, решение в лоб – чтобы показать, что это возможно и без других программ. По идее файл надо грузить/резать
частями.
Ещё и кодировку текста надо определять (
FB2 идёт текст в UTF-8 - ИМХО, его нужно переделывать в Windows-1251 ).
И тэги символов (&) заменять на сами символы (&).
Ник писал(а):Давайте уж договоримся, что все тексты нужно временно (пока Гислер не сделает полноценную поддержку УНикода) сводить в Windows-1251.
Поддерживаю.
Ник писал(а):для поисковика сделать лог-файл + показывать предупреждения, что типа это не та кодировка - не могу найти - и в конце работы писать список файлов не с той кодировкой
А как он узнает, что кодировка та?
А если узнает, зачем выдывать ошибки? Сделать, чтобы кодировка была та, конвертировать.
Добавлено: Чт авг 16, 2007 15:31
Ник
Моторокер писал(а):Работает хоть быстрее?
Медленнее намного...
И мусор остаётся (что естественно).
Лучше посмотрите, плз, скрипт от FB2 to Any - там, ИМХО, совсем легко - а прога уже отлаженная...
Алексей!

Думаю данный плагин + GetText решают, наконец, проблему поиска в RTF!
Спасибо большое!

Конечно, по удобству интерфейса в этой операции ТК не дотягивает до AVSearch - но важна принципиальная способность искать...
Добавлено: Чт авг 16, 2007 15:59
Ник
Моторокер писал(а):как он узнает, что кодировка та?
Советую скачать и внимательно прочитать описание View64 (кстати - был бы идеальный конвертор для данного плагина - но автор куда-то делся...):
файлы, начинающиеся с последовательности байт $FE$FF или $FF$FE, всегда интерпретируются как тексты в UTF-16, с $EF$BB$BF - как тексты в UTF-8
Добавлено: Чт авг 16, 2007 16:11
Stepan_Lameroff
GetTextIFilter ALPHA, Version 0.0.1.24023
bin+src
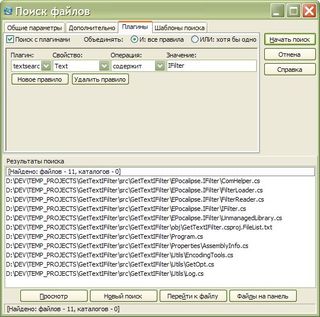
Для работы требуется .Net Framework 2.0+
Известные проблемы:
Не работает с Adobe 8+ AcroIF.dll (решается путем добавления %ProgramFiles%\Adobe\Acrobat 8.0\Acrobat\ в PATH)
C Foxit PDF IFilter работает нормально.
Параметры командной строки:
/(-)s <полный путь к исходному файлу> ({In})
/(-)d <путь к файлу с извлеченным текстом> ({Out})
[/(-)l] запись ошибок и исключений в лог (error.txt в каталоге программы)
[/(-)? | /(-)h | --help ] думаю понятно
Посмотреть список присутствующих в системе фильтров можно при помощи
IFilter Explorer
Много качественных фильтров
IFilterShop
Пинки, пожелания и предложения слать (посылать можно тоже
) мой_ник at mail.ru
Добавлено: Чт авг 16, 2007 16:31
Моторокер
Ник писал(а):описание View64
Я про то же.
Только если уже узнали, что кодировка «неверная», то об этом говорить не надо, а надо привести к «верной».
Добавлено: Чт авг 16, 2007 18:22
Alextp
Ник
--SilverCoders DocToText - говорит, не может конвертировать. Может, какие проблемы с именами?
Руками попробовал - он из файла делает UTF-8 и что с этим делать?
Я добавлю ключ {UTF8} для автоматической конвертации UTF-8 -> Text.
Также {OEM}. Еще какие-нибудь нужно? {RTF}? {UTF16}?